ニュースやSNSで「この画像は拡散モデルで生成された」という表現を見かけることが増えました。画像生成AIの技術解説記事でも、必ずと言っていいほど登場する言葉です。
しかし「拡散」という言葉から具体的に何をしている技術なのか、GANやVAEといった他の生成モデルと何が違うのか、ピンとこない方も多いのではないでしょうか。
一言でいえば拡散モデルとは、データに少しずつノイズを加えて壊し、その逆の手順でノイズを取り除きながらデータを作り出す仕組みの深層学習モデルです。
この記事では、拡散モデルの意味や仕組み、GAN・VAEとの違い、実際の使われ方についてわかりやすく解説します。
拡散モデルとは
拡散モデルとは、画像や音声などのデータを生成する深層学習モデルの一種です。英語ではDiffusion Modelと呼ばれます。
データに段階的にノイズを加えていく過程と、ノイズから元のデータに近いものを少しずつ復元していく過程の両方をニューラルネットワークに学習させる点が特徴です。
生成されたことがない新しい画像を作り出す「生成AI」の中核技術として、近年急速に広まりました。
拡散モデルの由来・発想
拡散モデルという名前は、物理学でインクが水の中に広がっていく現象を指す「拡散」からきています。
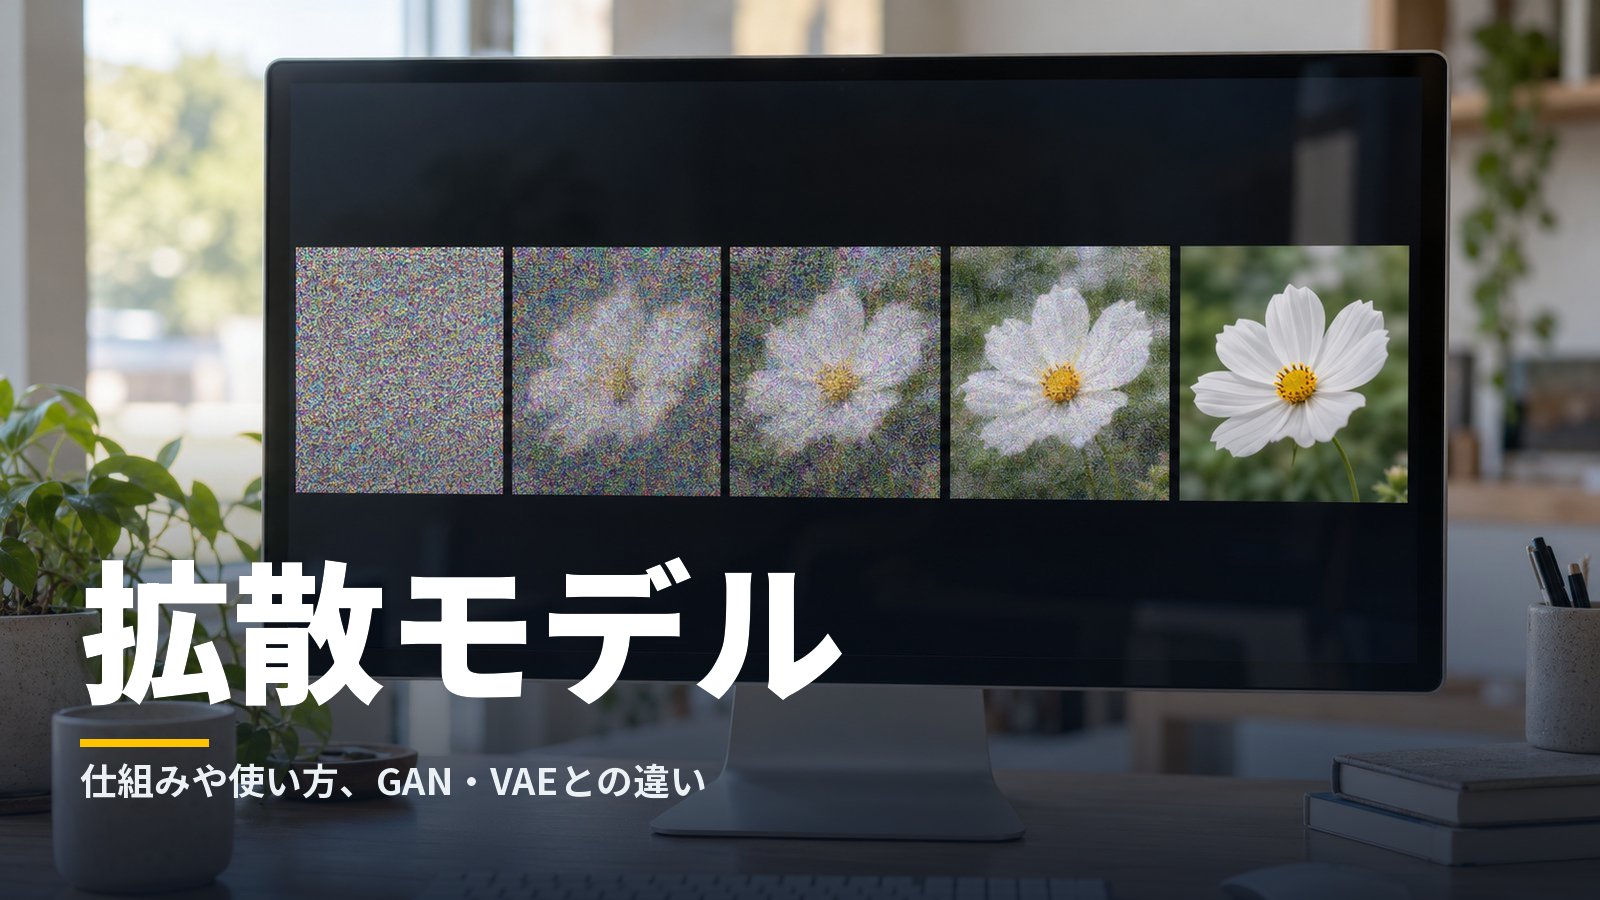
きれいな絵が少しずつノイズによって崩れ、最後には完全なランダムな砂嵐のような状態になる様子を思い浮かべてみてください。
拡散モデルは、この崩れていく過程を逆再生するようにして、ノイズだらけの状態から元の絵に近いものを描き起こす発想に基づいています。
この基本的な考え方を体系化した研究手法が広く知られるようになったことをきっかけに、画像生成分野の主流技術として注目を集めるようになりました。
拡散モデルの仕組み
拡散過程
拡散過程とは、元のデータに少しずつノイズを加えていき、最終的に完全なランダムノイズに近づける過程のことです。
この過程自体には学習は必要なく、あらかじめ決められた手順でノイズを加えていきます。
逆拡散過程
逆拡散過程とは、ノイズだらけの状態から、各ステップでどのようなノイズが加わったかを推定し、少しずつ取り除いていく過程です。
この逆方向の推定をニューラルネットワークに学習させることで、ランダムノイズから自然なデータを作り出せるようになります。
生成時には、純粋なランダムノイズから出発し、学習済みのネットワークが何十回、何百回とノイズ除去を繰り返すことで、最終的に一枚の画像などが完成します。
拡散モデルの種類
- ピクセル空間で直接ノイズ除去を行う基本的な拡散モデル
- 画像を圧縮した潜在空間でノイズ除去を行う潜在拡散モデル(Latent Diffusion Model)
- テキストなどの条件を与えて生成内容を制御する条件付き拡散モデル
中でも潜在拡散モデルは、計算量を大きく抑えられることから、実用的な画像生成サービスで広く採用される方式になっています。
拡散モデルの使い方・活用例
拡散モデルの代表的な活用例は、テキストから画像を生成する「text-to-image」です。
利用者が「夕焼けの富士山、水彩画風」のような文章を入力すると、モデルがその内容に沿った画像をノイズから少しずつ描き起こします。
- テキストからの画像生成(text-to-image)
- 画像の一部分だけを描き直すインペインティング
- 既存画像の画風を変換するスタイル変換
- 音声や動画、分子構造の生成といった画像以外の分野への応用
画像生成AIサービスの多くが拡散モデルを中核技術として採用しているとされており、研究・実用の両面で発展が続いている分野です。
拡散モデルとGANの違い
GAN(敵対的生成ネットワーク)は、生成器と識別器という2つのネットワークを競わせながら学習させる生成モデルです。
拡散モデルはノイズ除去を繰り返して1つのデータを作る方式であるのに対し、GANは一度の計算で画像を生成できる点が大きく異なります。
| 観点 | 拡散モデル | GAN |
|---|---|---|
| 生成の仕組み | ノイズ除去を繰り返して生成 | 生成器と識別器の競い合いで生成 |
| 生成速度 | 比較的遅い傾向 | 比較的速い傾向 |
| 出力の多様性 | 多様なサンプルを得やすい | モード崩壊が起きやすいとされる |
| 学習の安定性 | 比較的安定しやすい | 調整が難しい場合がある |
GANは学習がうまく噛み合わないと同じようなパターンばかり生成してしまう「モード崩壊」という課題が指摘されており、拡散モデルはこの点で優位とされています。
拡散モデルとVAEの違い
VAE(変分オートエンコーダー)は、データを一度圧縮した表現に変換し、そこから元のデータに近いものを再構成する生成モデルです。
VAEは圧縮と復元を1段階で行うのに対し、拡散モデルは多数のステップを重ねて少しずつデータを復元していく点が異なります。
一般に、VAEは学習や生成が速い一方で、生成物がやや不鮮明になりやすいとされ、拡散モデルは時間をかける分、より精細な出力を得やすいと言われています。
なお潜在拡散モデルは、VAEに似た仕組みで画像を圧縮した上で拡散処理を行っており、両者の考え方を組み合わせた技術ともいえます。
拡散モデルのメリット
- 多様で高品質な出力が得られやすい
- GANに比べて学習が安定しやすい
- テキストなど条件を与えた生成との相性が良い
- 画像以外の音声・動画・分子構造などにも応用できる
拡散モデルの注意点・課題
拡散モデルは1つのデータを作るのに多数のステップを重ねるため、GANなど一部の手法と比べて生成に時間がかかりやすい点が課題とされています。
この課題に対しては、生成ステップ数を減らす工夫や、潜在空間で処理する方法など、計算負荷を抑えるための研究が進められています。
また生成AI全般に共通する課題として、学習データの偏りや著作権に関わる論点、生成物の真偽が見分けにくくなる点なども、利用する上で意識しておきたいポイントです。
拡散モデルによくある誤解
拡散モデルは「既存の画像を組み合わせているだけ」と誤解されることがありますが、実際には学習した特徴をもとに新しいパターンを生成しています。
また「拡散モデルは画像生成専用の技術」と思われがちですが、実際には音声や動画、分子構造の設計など、画像以外の分野にも応用が広がっています。
さらに、拡散モデルが常にGANより優れているわけではなく、用途によっては生成速度を重視してGANなど別の手法が選ばれる場合もあります。
まとめ
拡散モデルとは、データにノイズを段階的に加える拡散過程と、ノイズから元のデータを復元する逆拡散過程を学習する生成AIの技術です。
GANに比べて多様で安定した出力を得やすく、VAEに比べて精細な出力を得やすいとされますが、その分生成に時間がかかりやすい点が課題です。
テキストからの画像生成をはじめ、音声や動画など幅広い分野への応用が進んでおり、生成AIを理解するうえで欠かせない基礎技術といえます。
言葉の意味だけでなく、GAN・VAEとの違いや仕組みを押さえておくと、生成AIに関するニュースや技術解説がより理解しやすくなるはずです。
コメント