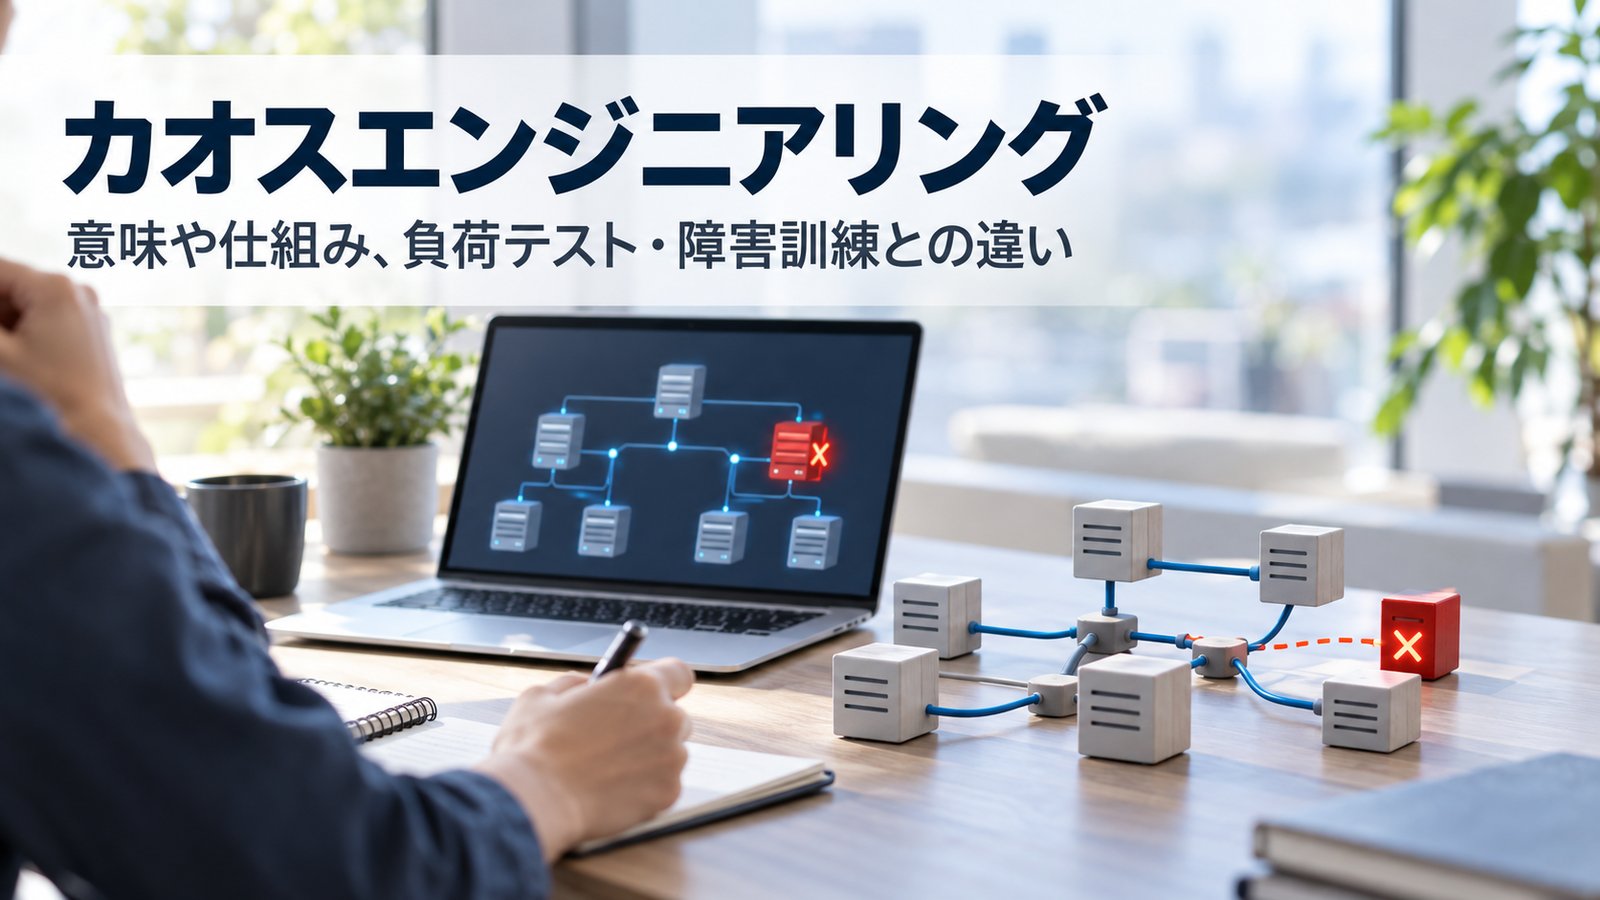
クラウドやマイクロサービスを扱うIT業界の記事で「カオスエンジニアリング」という言葉を見かけることが増えています。障害対応やシステム信頼性の話題でよく登場する用語です。
わざと障害を起こすテスト、と聞くと「なぜそんな危険なことをするのか」「普通のテストと何が違うのか」と疑問に思う方も多いのではないでしょうか。
一言でいえば、カオスエンジニアリングとは、意図的に障害を発生させてシステムの耐障害性を確かめ、改善につなげるエンジニアリングの考え方です。
この記事では、カオスエンジニアリングの意味や仕組み、具体的な進め方、フォールトトレランス・負荷テスト・障害訓練との違いについてわかりやすく解説します。
カオスエンジニアリングとは
カオスエンジニアリングとは、本番環境やそれに近い環境に意図的に障害や異常な状態を発生させ、システムがどれだけ耐えられるかを調べる手法です。
単発のテストではなく、障害を注入して観察し、見つかった弱点を直すという取り組みを継続的に繰り返す点が特徴です。
目的は、事前には想定していなかった障害が起きても、サービス全体が止まらないように備えることにあります。
カオスエンジニアリングの由来
カオスエンジニアリングという考え方は、2010年代初頭に米国の動画配信企業であるNetflixが実践を始めたことで広く知られるようになったといわれています。
大規模な分散システムを運用するなかで、サーバーがいつ落ちても困らない仕組みを作るために生まれた取り組みです。
Netflixが開発したChaos Monkeyというツールは、ランダムにサーバーを停止させることで、個々の障害に対する耐性を自動で確認する仕組みでした。
クラウドやマイクロサービスの構成が一般的になった現在では、同様の考え方が多くの企業に取り入れられています。
カオスエンジニアリングの仕組み
カオスエンジニアリングは、思いつきで障害を起こすわけではなく、一定の手順に沿って進められます。
まず「この障害が起きてもサービスは正常に動くはずだ」という仮説を立てます。
そのうえで、実際にその障害を注入し、システムの挙動や利用者への影響を観察します。
想定と違う結果が出た場合は、その原因となった設計上の弱点を特定し、改善策を講じます。
このサイクルを繰り返すことで、システムの耐障害性を段階的に高めていくのが基本的な流れです。
注入される障害にはどんな種類がある?
カオスエンジニアリングで注入される障害や異常には、いくつかの代表的な種類があります。
- サーバーやコンテナを強制的に停止させる
- ネットワークに遅延やパケットロスを発生させる
- 依存するAPIやデータベースの応答を止める
- CPUやメモリを高負荷状態にする
- データセンターやリージョン単位の障害を模擬する
システムの構成や目的に応じて、どの障害をどの範囲で起こすかを選びながら実施します。
従来のテストとの違いは?
一般的なテストは、あらかじめ想定した正常なケースと異常なケースを確認する手法です。
これに対してカオスエンジニアリングは「想定していなかった事態が起きても壊れないか」を問い続ける点が異なります。
設計段階では見えにくかった単一障害点や、複数サービス間の依存関係の弱さを見つけやすいことが利点です。
カオスエンジニアリングとフォールトトレランスの違い
フォールトトレランスとは、障害が起きても機能を維持できるように設計されたシステムの性質そのものを指す言葉です。
一方のカオスエンジニアリングは、そのフォールトトレランスが実際に機能しているかどうかを、意図的に障害を起こして確かめる手法です。
つまりフォールトトレランスが目指す「状態」であり、カオスエンジニアリングはそれを検証する「行為」という関係にあります。
カオスエンジニアリングと負荷テストの違い
負荷テストは、想定されるアクセス量や処理量をかけて、システムの性能や応答速度を確認する手法です。
負荷が高まることは想定の範囲内であり、どこまで耐えられるかという限界を調べる目的が中心となります。
これに対してカオスエンジニアリングは、負荷の大小ではなく「障害そのもの」を起こし、想定外の事態への対応力を確認します。
カオスエンジニアリングと障害訓練の違い
障害訓練は、障害が発生した際に運用担当者がどう対応するか、手順や連携を確認する取り組みです。
確認の主な対象は人や組織の動きであり、あらかじめ用意したシナリオに沿って実施されることが多くなります。
カオスエンジニアリングはシステム自体の挙動を確認する手法であり、人の対応力を見る障害訓練とは目的が異なります。両者を組み合わせて活用する組織もあります。
3つの違いを比較する
ここまでの違いを、目的や確認する対象の観点から表にまとめます。
| 手法 | 主な目的 | 確認する対象 |
|---|---|---|
| カオスエンジニアリング | 想定外の障害への耐性を検証する | システム全体の挙動 |
| フォールトトレランス | 障害が起きても機能を維持する設計上の性質 | アーキテクチャそのもの |
| 負荷テスト | 想定される負荷での性能を確認する | 処理性能や応答時間 |
| 障害訓練 | 障害発生時の対応手順を確認する | 運用担当者の対応 |
カオスエンジニアリングの進め方の具体例
たとえば大規模なECサイトが、セール開始前にカオスエンジニアリングを実施する場面を考えてみます。
決済サービスへの接続が突然切れるという障害をあえて発生させ、注文データが失われずに処理が続けられるかを確認します。
もし問題が見つかれば、処理の仕組みを見直し、本番でセールが始まる前に対策を済ませておくことができます。
カオスエンジニアリングのメリット
最大のメリットは、利用者に影響が出る前に、システムの弱点を見つけて直せることです。
障害が起きたときに初めて問題が発覚するのではなく、事前に対策を講じられるため、サービス停止のリスクを下げやすくなります。
また、障害が起きても冷静に対応できるという、組織としての経験や自信を積み重ねられる点もメリットといえます。
カオスエンジニアリングを行う際の注意点
本番環境で障害を起こす以上、利用者への影響を最小限に抑える工夫が欠かせません。
影響範囲を小さく区切ったり、問題が起きた際にすぐ元の状態に戻せる仕組みを用意したりすることが前提となります。
関係者への事前の周知や、実施時間帯の調整など、慎重な計画のもとで進める必要があります。
カオスエンジニアリングのよくある誤解
「本番環境を無計画に壊すだけの乱暴な手法」と誤解されることがありますが、実際は仮説検証に基づく計画的な取り組みです。
また「大規模なシステムでしか使えない」と思われがちですが、小規模なシステムでも考え方自体は応用できます。
単に障害を起こして終わりではなく、観察と改善を繰り返す点を理解しておくことが大切です。
まとめ
カオスエンジニアリングとは、意図的に障害を発生させてシステムの耐障害性を検証し、改善につなげる手法です。
想定済みのケースを確認する従来のテストや負荷テストとは異なり、想定外の事態への対応力を問い続ける点が特徴です。
フォールトトレランスという設計上の性質を実際に検証する手段であり、人の対応力を見る障害訓練とも補完的な関係にあります。
クラウドやマイクロサービスが広がる現代において、システムの信頼性を高めるための重要な考え方として理解しておきたい用語です。
コメント