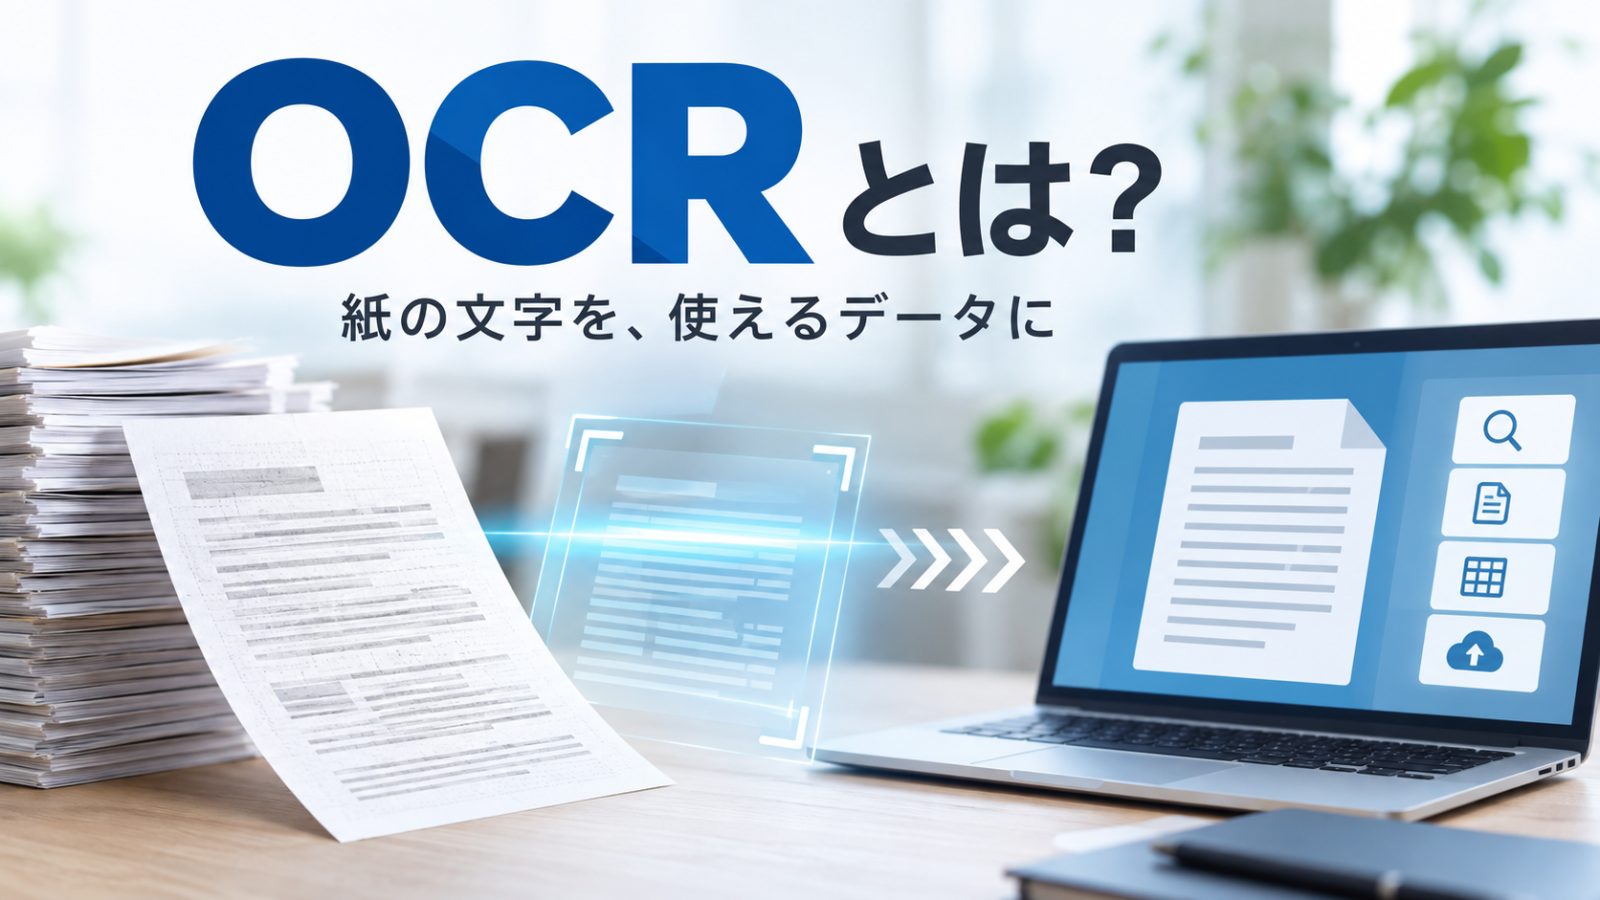
OCRは、紙の書類や画像に含まれている文字を読み取り、コンピューターで扱える文字データへ変換する技術です。
レシートの金額を読み取ったり、紙の資料を検索可能なPDFにしたりするなど、身近なところでも利用されています。
近年ではAI技術の発展によって認識性能や文書解析能力が向上し、「AI-OCR」と呼ばれるサービスも広く利用されるようになりました。
この記事では、OCRの意味や基本的な仕組み、スキャンとの違い、AI-OCRとの関係についてわかりやすく解説します。
OCRとは
OCRとは「Optical Character Recognition」の略で、日本語では一般に「光学文字認識」と呼ばれます。
画像として存在している文字を認識し、コンピューターで処理できる文字データへ変換する技術です。
たとえば、紙に次のような文字が印刷されているとします。
「請求金額:12,800円」
この紙を単純に撮影した場合、コンピューターから見れば基本的には画像です。
OCRを使って画像内の文字を認識すると、「請求金額:12,800円」というテキストデータとして取り出せるようになります。
テキストデータになれば、コピー、検索、編集、集計などの処理が可能になります。
OCRの基本的な仕組み
OCRの具体的な処理方法は製品やシステムによって異なりますが、一般的には画像の前処理、文字領域の検出、文字認識などの処理を組み合わせて文字を読み取ります。
画像を取得する
最初に、文字が含まれている画像を用意します。
スキャナーで読み込んだ書類だけでなく、スマートフォンやデジタルカメラで撮影した画像などもOCRの対象になります。
画像を補正する
撮影した画像には、傾き、影、ノイズ、明るさのばらつきなどが含まれている場合があります。
必要に応じて画像を補正し、文字を認識しやすい状態にします。
文字が存在する領域を検出する
画像のどこに文字や文章が存在しているのかを特定します。
文書によっては文章だけでなく、表、見出し、複数の段組みなどが存在するため、レイアウトの解析が重要になる場合もあります。
文字を認識する
検出した文字領域から、それぞれの文字を認識します。
現在のOCRでは、機械学習やディープラーニングを利用した文字認識技術も活用されています。
テキストデータとして出力する
認識した文字をテキストデータとして出力します。
用途によっては単純なテキストだけでなく、元の文書レイアウトをできるだけ維持したデータや、検索可能なPDFなどとして出力することもできます。
OCRでできること
OCRは、紙や画像として保存されている情報をデジタルデータとして活用するために利用されています。
代表的な用途として、次のようなものがあります。
- レシートから店舗名、購入日、商品名、金額などを読み取る
- 請求書から請求金額や日付などを読み取る
- 名刺から氏名、会社名、電話番号などを読み取る
- 紙の資料や書籍をテキストデータ化する
- スキャンしたPDFを文字検索できるようにする
- 写真に写っている文章をテキストとして取り出す
- 各種帳票の情報を業務システムへ入力する
大量の書類を扱う業務では、OCRによって手作業によるデータ入力を減らせる可能性があります。
OCRとスキャンの違い
OCRとスキャンは混同されることがありますが、役割が異なります。
スキャンは、紙の文書などを画像としてデジタル化する処理です。一方、OCRは、その画像に含まれている文字を認識して文字データへ変換します。
たとえば、紙の契約書をスキャンしてPDFにしたとしても、各ページが単なる画像として保存されている場合があります。
この状態では、PDF内の文章を文字として検索したりコピーしたりできないことがあります。
OCRを適用して文字情報を付与すれば、検索可能なPDFを作成できます。
つまり、
「紙の文書 → スキャン → 画像データ → OCR → 文字データ」
という関係として考えると理解しやすいでしょう。
OCRとAI-OCRの違い
近年は「AI-OCR」という言葉も使われています。
AI-OCRに統一された厳密な定義があるわけではありませんが、一般的には機械学習やディープラーニングなどのAI技術を活用したOCR製品やサービスを指します。
OCRそのものも技術の進歩によって高度化しているため、「OCR」と「AI-OCR」を完全に別の技術として区別できるわけではありません。
AI技術を利用することで、さまざまな字体や複雑な帳票への対応、文書レイアウトの解析など、高度な処理を実現しているシステムがあります。
また、文字を認識するだけでなく、文書の種類を判定したり、必要な項目を抽出したりする機能を組み合わせたサービスも提供されています。
OCRの認識精度を左右する要素
OCRは便利な技術ですが、どのような文字でも必ず正しく認識できるわけではありません。
認識精度には、元となる画像や文書の状態が大きく影響します。
たとえば、次のような条件では認識が難しくなることがあります。
- 画像の解像度が低い
- 文字がぼやけている
- 文書が大きく傾いている
- 文字がかすれている
- 背景と文字のコントラストが低い
- 特殊なフォントが使用されている
- 手書き文字が含まれている
- 複雑な表やレイアウトになっている
- 文字の一部が欠けている
また、「0」と「O」、「1」と「I」のように形が似ている文字が誤認識される場合もあります。
日本語でも、形の似た漢字やカタカナなどが誤って認識される可能性があります。
OCRを利用するときの注意点
OCRによって出力されたテキストは、必要に応じて元の文書と照合することが重要です。
特に契約書、請求金額、口座情報、住所、氏名など、誤認識による影響が大きい情報については注意が必要です。
OCRの結果をそのまま正しい情報として扱うのではなく、用途や重要度に応じて人による確認やシステム上の検証処理を組み合わせます。
OCRと生成AIの組み合わせ
OCRは、生成AIと組み合わせることもできます。
生成AIや大規模言語モデル(LLM)は基本的にテキストを扱うことを得意としているため、紙の資料や画像内の文章をOCRによってテキスト化することで、その内容を後続の処理に利用できます。
たとえば、
「紙の資料 → スキャン・撮影 → OCR → テキスト化 → LLMによる要約や分類」
といった処理が考えられます。
また、OCRで取得した文書を検索システムに登録し、RAG(Retrieval-Augmented Generation:検索拡張生成)などの仕組みから利用することも可能です。
ただし、現在のマルチモーダルAIには画像や文書を直接解析できるものもあるため、すべての生成AIシステムでOCRを独立した処理として実行する必要があるわけではありません。
OCRは紙とデジタルデータをつなぐ技術
OCRの大きな役割は、人間には読めるもののコンピューターからは画像として扱われている文字を、利用可能な文字データへ変換することです。
紙の書類や画像を単純にデジタル化するだけでなく、検索、コピー、編集、集計、システム連携などができるデータへ変換できることに大きなメリットがあります。
さらに、AI-OCRや生成AIなどと組み合わせることで、文字を読み取るだけではなく、文書の分類、情報抽出、要約、検索などへ活用できるようになっています。
OCRは、紙や画像として蓄積されてきた情報をデジタル環境で活用するための基礎的な技術の一つといえるでしょう。
コメント